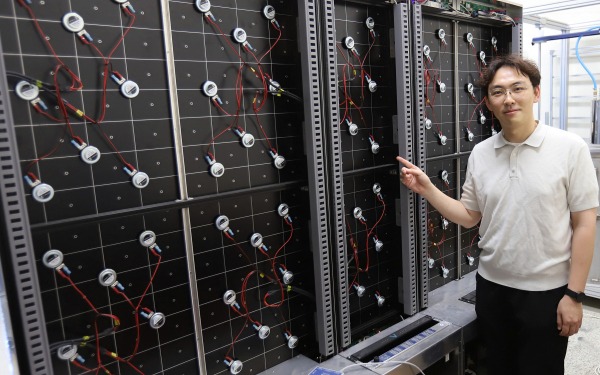
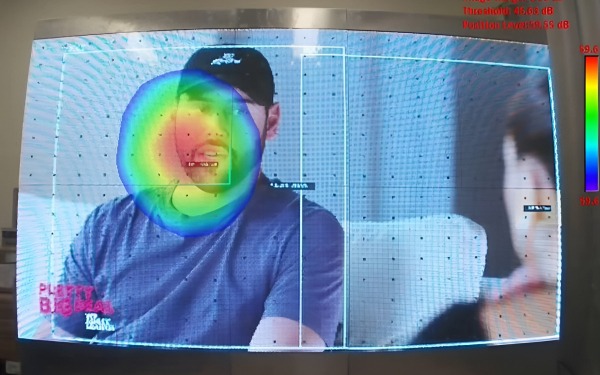
Исследователи из Корейского института машиностроения и материалов представили технологию генерации звука из экрана – он исходит в точности из того места, где на текущей картинке находится источник звука. Им может быть рот говорящего человека или озвученный объект — причем если предмет перемещается, то звук движется по экрану вместе с ним. Это позволяет обеспечить идеально точное сопровождение визуального изображения звуком.
Звучащие экраны создаются давно, но до сих пор это была просто комбинация динамика и пластины для вывода картинки. Главная проблема именно в точном позиционировании источника звука, так как даже если собрать массив из множества крохотных динамиков, их сигналы все равно будут мешать друг другу. Вибрации в такой системе накладываются друг на друга, гасятся или усиливаются, искажаются и т.д. Зритель не может вычленить источник звука – основная задача остается нерешенной.
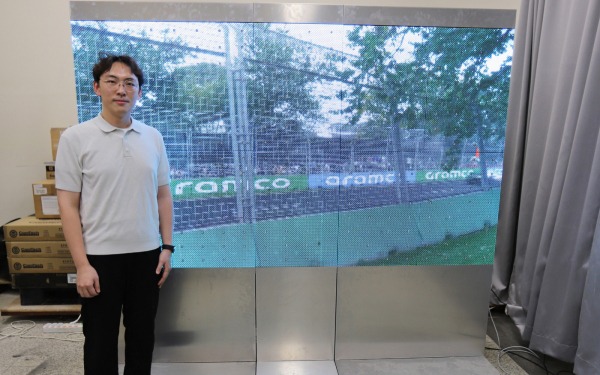
Строго говоря, решить эту задачу инженерными методами практически невозможно, поэтому корейские специалисты применили математический алгоритм для управления вибрациями и ИИ для поиска источника звука на изображении. ИИ анализирует картинку, чтобы установить источник звука и параметры его распространения, после чего в реальном времени корректирует генерацию аудиосигналов. Звук в прямом смысле исходит из одной условной точки на экране, а на остальном пространстве подавляется. И все это происходит в динамике.
Результаты очень хорошие, точность выбора нужной зоны звукоизлучения достигает 99,9%, что подтверждено при помощи поисковой акустической камеры. А так как конструкция модульная, то технологию несложно адаптировать под экраны произвольных размеров. И вот тут сразу возникает сложность – перемещение источника звука на маленьком экране незаметно и не имеет смысла для зрителя. Это актуально только для сверхбольших экранов — например, на выставках и стадионах.